Arm FEAT_MOPS让软件memcpy, memset更加简单标准高效
FEAT_MOPS引入专门的memcpy, memset指令,让软件通过简单三条指令完成任何数据大小,地址对齐的memcpy, memset操作。同时让CPU微构架实现硬件自己来优化内存访问过程,让memcpy, memset这类软件中最常用的操作标准化,简单高效。
Arm A-profile架构v8.8-A/v9.3-A引入了专门用于memcpy和memset的指令(架构特性名为FEAT_MOPS),能利用不同CPU核微架构内存访问硬件设计带来的好处的同时,这些指令可以使软件广泛使用的memcpy, memset操作在Arm架构上标准化。可以克服之前的问题:需要针对不同的CPU核和不同的数据大小/地址对齐,使用不同的软件路径或是不同的软件库实现,才能利用CPU微架构内存访问设计带来的好处。
为什么需要专门的memcpy, memset指令?
memcpy, memset在软件中广泛,频繁使用,可以明显影响软件性能。
Google研究表明,软件对memcpy, memmove的库函数调用能达到数据中心时间的4~5%.

https://static.googleusercontent.com/media/research.google.com/en//pubs/archive/44271.pdf
Facebook的研究也表明,memcpy,memmove消耗了最大的内存周期:

https://dl.acm.org/doi/10.1145/3373376.3378450
还有研究表明,将近70%的memcpy是针对小于128B的数据,~80%是对小于256B的数据。
Arm架构是RISC,它有简洁的LDR (Load), STR (Store)内存访问指令。之前在A64指令集中,有基本的
- 单寄存器LDR/STR指令: 一条LDR指令可以从内存中load一个 1-byte, 2-byte, 4-byte, 8-byte, 16-byte数据到一个寄存器,一条STR指令可以将一个寄存器中的1-byte, 2-byte, 4-byte, 8-byte, 16-byte数据存储到内存中.
- 双寄存器LDP/STP指令: 一条LDP指令可以从内存中load两个4-byte, 8-byte数据到两个寄存器,一条STP指令可以将两个寄存器中的两个4-byte, 8-byte数据存储到内存中。 LDP/STP有数据地址对齐要求。
之前的memcpy, memset的实现可以利用这些指令组合实现,还可以利用NEON/FPU, SVE2的LDR/STR, LDP/STP,这些指令支持16-byte数据访问。
因为CPU微架构的不同,为一个微架构上优化过的memcpy, memset函数并不总能在其他微架构的CPU核上得到同样优化的性能,这可能是因为:
- 不同CPU微架构有不同的内存访问pipeline数量,不同的硬件数据通路位宽,不同outstanding访问数量支持
- 不同的硬件prefetch设计
- 大小核有不同的硬件内存访问设计
- 不同CPU微架构对非对齐访问的支持效率不一样
- 有些CPU可以从使用NEON,SVE2内存访问获益,而有些CPU不能
另外采用LDR/STR指令组合实现的memcpy, memset的过程中通常需要使用更多指令和寄存器,这会带来一定的寄存器使用压力。
为了帮助软件可以得到优化的memcpy和memset性能,arm通常会提供这些CPU的software optimization guide, 其中会包含基本的pipeline信息和如何通过LDR/STR指令得到好的memcpy和memset性能。例如在Cortex-A76的software optimization guide中提到:
https://documentation-service.arm.com/static/5ed4bd67ca06a95ce53f917d?token=
The Cortex-A76 processor includes two load/store pipelines, which allow it to execute two 128 bit load uops and one 128 bit store uop every cycle:
因此建议采用NEON/FPU寄存器的 LDP/STP指令组合实现memcpy:
Loop_start:
SUBS X2,X2,#192
LDP Q3,Q4,[x1,#0]
STP Q3,Q4,[x0,#0]
LDP Q3,Q4,[x1,#32]
STP Q3,Q4,[x0,#32]
LDP Q3,Q4,[x1,#64]
STP Q3,Q4,[x0,#64]
LDP Q3,Q4,[x1,#96]
STP Q3,Q4,[x0,#96]
LDP Q3,Q4,[x1,#128]
STP Q3,Q4,[x0,#128]
LDP Q3,Q4,[x1,#160]
STP Q3,Q4,[x0,#160]
ADD X1,X1,#192
ADD X0,X0,#192
BGT Loop_start
而在通常与Cortex-A76配对使用的Cortex-A55 CPU的软件优化指南 (https://developer.arm.com/documentation/EPM128372/latest/) 中提到:
the store pipeline width is 128 bits, the load data path width is 64 bits, all load instructions that read 64 bits of data take a single cycle to issue if the address is 64-bit aligned and all load instructions that read 128-bits of data take two cycles to issue if the address is 64-bit aligned.
因为issue能力和data path位宽不同,因此建议采用通用寄存器的 LDP/STP指令组合实现memcpy:
loop_start:
STP x3, x4, [x0, #-0x30]
SUBS x2, x2, #0x40
LDP x3, x4, [x1, #-0x30]
STP x5, x6, [x0, #-0x20]
LDP x5, x6, [x1, #-0x20]
STP x7, x8, [x0, #-0x10]
LDP x7, x8, [x1, #-0x10]
STP x9, x10, [x0], #0x40
LDP x9, x10, [x1], #0x40
B.NE loop_start
通常, 有可能的话,我们建议指定合适的-mcpu编译和链接选项来得到较好的结果。但在大小核同时存在的系统,软件难以为运行在不同的CPU核上动态选择不同的memcpy, memset实现,而是使用统一的实现。
除此之外,因为LDP/STP指令还有数据对齐要求(访问非对齐数据地址会导致data abort异常),针对不同的数据大小也可能需要不同的指令组合。我们可以参看一个newlib中的memcpy实现:
我们可以看到,它针对不同数据大小和对齐设计了不同代码路径进行处理。指令数量和寄存器的使用较多。
Arm引入的专门的memcpy, memset指令正是用来解决这些问题的:使用标准化统一的指令进行memcpy, memset,同时可以跨CPU微架构实现地利用硬件优化。
Arm memcpy, memset指令
FEAT_MOPS架构扩展引入了专门的memcpy, memset指令序列:
- CPY***: Memcpy指令系列
- SET***: Memset指令序列
这些指令的设计需要考虑如何进行安全的memcpy,如何处理在大块内存memcpy或memset指令过程中出现中断或是异常的情况,还有memcpy, memset过程中出现迁移到不同CPU核上(不同核有不同的memcpy,memset指令微架构实现)等问题。
有一个经典的memcpy问题,如何对memcpy(src, dst, size)进行安全的copy操作?
这里要考虑的是src和dst的内存有没有overlap的问题, 可以分成3种情况:
- 没有overlap

这种情况不需要特殊考虑
- dst overlaps src

这种情况下dst前部与source后部有重合,如果从src开头拷贝,会出现src前部拷贝到dst 前部(也即src的后部),导致src后部在拷贝之前被覆盖的情况:

如果从src的尾部往头部方向拷贝,可以避免这个问题。
- src overlaps dst

这种情况下src前部与dst后部有重合,从src头部开始拷贝还是安全的。
在src和dst有 overlap的情况下,需要考虑如何避免overlap部分的src不能被dst覆盖。这涉及到memcpy是前向(Forward,从内存的低地址往高地址方向)拷贝还是后向(Backward,从内存的高地址往地址方向)拷贝。
Arm memcpy, memset指令三部曲
Arm的CPY***, SET***指令序列(*表示指令还有附加信息)采用了三部曲的设计来完成memcpy, memset操作:
- Prolog -- 开头
- Main -- 主体
- Epilog -- 结尾

例如以下指令:
- CPYP** : Memcpy Prolog
- CPYM** : Memcpy Main
- CPYE** : Memcpy Epilog
任何数据大小的Memcpy的操作可以由CPYP** ,CPYM** , CPYE** 这三条指令(三步)来完成。
架构上并未规定每步微架构应该做什么,这个自由度留个CPU硬件微架构。一般来说,
- 在Prolog阶段,它做一些为后面Main的准备工作,如配置copy的方向,一部分的开头的拷贝工作,如拷贝一些数据直到数据地址达到一定的对齐要求,更新寄存器等。
- 在Main阶段,预期它完成主体的Memcpy工作,更新寄存器
- 在Epilog 阶段,它完成扫尾工作,更新寄存器
在Prolog,Main,Epilog阶段各拷贝多少数据由微架构实现决定(Implementation defined)。对于一些较小的memcpy数据,允许在Prolog阶段就拷贝完,Main, Epilog阶段的指令并不需要做什么事情。
虽然在软件上看这三步合理,但在硬件实现上还需考虑:
- 硬件上每个micro-ops (uops,CPU硬件微架构通常会将这些指令分解为pipeline里的微操作)单次可以copy的block size
- 指令的latency和中断,异常处理
- 这三阶段为不同的对齐,拷贝大小做的工作
- 如何更新存储地址指针和数据大小的寄存器
memcpy, memset指令的基地址和数据大小寄存器的更新
为了CPU核微架构设计的灵活性,FEAT_MOPS架构扩展支持memcpy, memset过程采用两种基地址和数据大小的更新方式: Option A和Option B. 由CPU核微架构设计选择Option A还是Option B.
Option A
这种方式在Prolog阶段将地址指针调整为memcpy, memset的最终地址。
地址指针在Main, Epilog过程中无需再次调整。
对于数据大小,当采用后向拷贝时它是个正值,当采用前向拷贝时它是个负值。数据大小在Prolog, Main, Epilog过程朝着0进行调整。
架构上规定,Prolog阶段硬件设置PSTATE.C为0来表示采用方式为Option A.
Option B
这种方式在Prolog, Main, Epilog 阶段根据每阶段拷贝大小调整地址指针。
对于数据大小,它总是个正值,拷贝的方式(Forward or Backward)由PSTATE.N来指示。
架构上规定,Prolog阶段硬件设置PSTATE.C为1来表示采用方式为Option B.
Memcpy指令
结合拷贝方向(Forward or Backward), FEAT_MOPS增加了如下memcpy指令:
CPY[F]Px [Xd]!, [Xs]!, Xn! //CPY[F]Px [dst]!, [src]!, num_bytes!
CPY[F]Mx [Xd]!, [Xs]!, Xn! //CPY[F]Mx [dst]!, [src]!, num_bytes!
CPY[F]Ex [Xd]!, [Xs]!, Xn! //CPY[F]Ex [dst]!, [src]!, num_bytes!
如果指令中带有F,表示它只支持Forward copy。没有F的话,表示由指令自己选择拷贝方向。
不管哪种方式,第一步CPYP指令执行前,CPYP指令中的Xd, Xs, Xn应被软件赋值为memcpy(dst, src, size)中dst, src和size,CPYP指令后,和后续的CPYM, CPYE中的Xd, Xs, Xn由前面所述的Option A,Option B方式更新。
可以让软件通过简单三条Prolog, Main,Epilog指令完成任何数据大小,地址对齐的memcpy操作。例如可以通过如下代码实现memcpy:
// memcpy(dst, src, size)
// dst is passed X0, src is passed X1, size is passed X2,
memcpy:
MOV x3, x0
CPYP [x3]!, [x1]!, x2!
CPYM [x3]!, [x1]!, x2!
CPYE [x3]!, [x1]!, x2!
RET
Memcpy Forward only指令
我们先来看CPYFP*, CPYFM*,CPYFE* 这些Forward only指令。
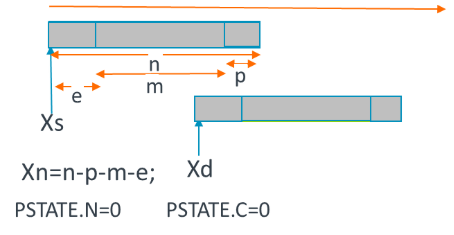
刚开始软件在CPYFP指令之前将copy的src基地址Xs_init设置到Xs, dst基地址Xd_init设置到Xd, 数据大小n设置到Xn。
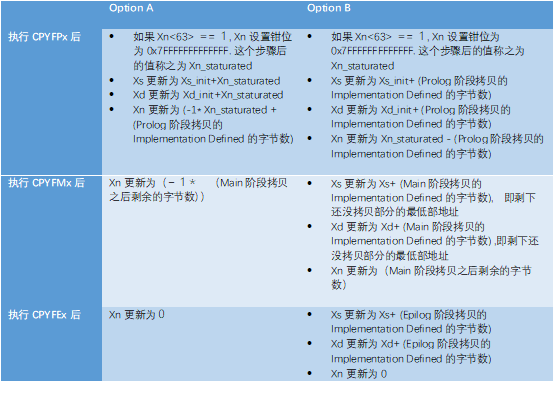
下面我们以一个CPYF* (前向copy) Option A为例,演示其方式。
- 最初软件将要copy的src基地址Xs_init设置到Xs, dst基地址Xd_init设置到Xd, 数据大小n设置到Xn

2. 执行 CPYFPx [Xd]!, [Xs]!, Xn!
Prolog阶段,拷贝implementation Defined大小(假设为p)数据,调整Xs=Xs_init+n, Xd=Xs_init+n, Xn=-(n-p)

3. 执行 CPYFMx [Xd]!, [Xs]!, Xn!
Main阶段,拷贝implementation Defined大小(假设为m)数据,调整Xn=-(n-p-m)

4. 执行 CPYFEx [Xd]!, [Xs]!, Xn!
Epilog阶段,拷贝implementation Defined大小(假设为e)数据,调整Xn=0

下面我们再以一个CPYF* (前向copy) Option B为例,演示其方式。
- 最初软件将要copy的src基地址Xs_init设置到Xs, dst基地址Xd_init设置到Xd, 数据大小n设置到Xn

2. 执行CPYFPx [Xd]!, [Xs]!, Xn!
Prolog阶段,拷贝implementation Defined大小(假设为p)数据,调整Xs=Xs_init+p, Xd=Xd_init+p, Xn=n-p

3.执行CPYFMx [Xd]!, [Xs]!, Xn!
Main阶段,拷贝implementation Defined大小(假设为m)数据,调整Xs=Xs_init +p+m, Xd=Xd_init+p+m, Xn=n-p-m

4. 执行CPYFEx [Xd]!, [Xs]!, Xn!
Epilog阶段,拷贝implementation Defined大小(假设为e)数据,调整Xs=Xs_init +p+m+e, Xd=Xd_init+p+m+e, Xn=n-p-m-e=0

Memcpy Generic指令
对于CPYP*, CPYM*, CPYE*这些没有在指令中指定前向copy(指令中没有F)的通用指令,CPU微架构实现可以选择Option A或是Option B, 拷贝过程是前向拷贝还是后向拷贝由src, dst, size来决定。采用Option B时,硬件通过设置PSTATE.N为表明前向(PSTATE.N=1)还是后向拷贝(PSTATE.N=0)。
指令copy的方向在CPYP时,由以下方式决定:
- 如果Xn<63:55> != 000000000, Xn设置钳位为0x7FFFFFFFFFFFFF. 这个步骤后的值称之为Xn_staturated
- 然后,如果Xs > Xd并且 (Xd + Xn_staturated ) > Xs, 那么方向为Forward;

如果 Xs < Xd 并且 (Xs + Xn_staturated ) > Xd, 那么方向为Backward;

其他情况由CPU微架构硬件实现决定哪个方向。
如果是前向拷贝,这些指令更新寄存器的方式与CPYFP*, CPYFM*, CPYFE*类似,这里不再赘述。下面主要讲一下后向拷贝更新寄存器的方式:
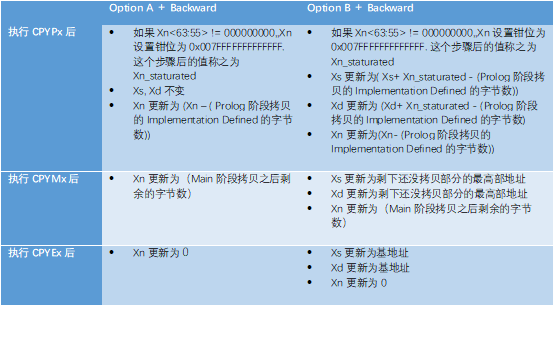
下面以Option A +Backward拷贝为例,演示其方式:
- 最初软件将要copy的src基地址Xs_init设置到Xs, dst基地址Xd_init设置到Xd, 数据大小n设置到Xn

2. 执行CPYPx [Xd]!, [Xs]!, Xn!
Prolog阶段,拷贝implementation Defined大小(假设为p)数据,调整寄存器Xn=n-p, Xs, Xd寄存器不变

3.执行 CPYMx [Xd]!, [Xs]!, Xn!
Main阶段,拷贝implementation Defined大小(假设为m)数据,调整寄存器Xn=n-p-m

4. 执行 CPYEx [Xd]!, [Xs]!, Xn!
Epilog阶段,拷贝implementation Defined大小(假设为e)数据,调整寄存器Xn=n-p-m-e=0
Linux kernel 已经支持FEAT_MOPS特性,可以参见
可参见下面Linux kernel 代码:
https://elixir.bootlin.com/linux/v6.13.6/source/arch/arm64/lib/memcpy.S#L251
#ifdef CONFIG_AS_HAS_MOPS
.arch_extension mops
SYM_FUNC_START(__pi_memcpy)
alternative_if_not ARM64_HAS_MOPS
b __pi_memcpy_generic
alternative_else_nop_endif
mov dst, dstin
cpyp [dst]!, [src]!, count!
cpym [dst]!, [src]!, count!
cpye [dst]!, [src]!, count!
ret
SYM_FUNC_END(__pi_memcpy)
较新的GCC和LLVM compiler都已经支持FEAT_MOPS, 通过加上-march=+mops选项编译下面代码
#include <string.h>
void memcopy_test(void * dst, void *src, int size)
{
memcpy(dst, src, size);
}
可以得到使用memcpy指令的代码:
memcopy_test:
sxtw x2, w2
cpyfp [x0]!, [x1]!, x2!
cpyfm [x0]!, [x1]!, x2!
cpyfe [x0]!, [x1]!, x2!
ret
Memset指令
FEAT_MOPS引入了memset指令:
SETPx  [dst]!, num_bytes!, src_data
SETMx  [dst]!, num_bytes!, src_data
SETEx  [dst]!, num_bytes!, src_data
Memset指令也有Option A,Option B,但没有memcpy的Forward和Backward的区分。
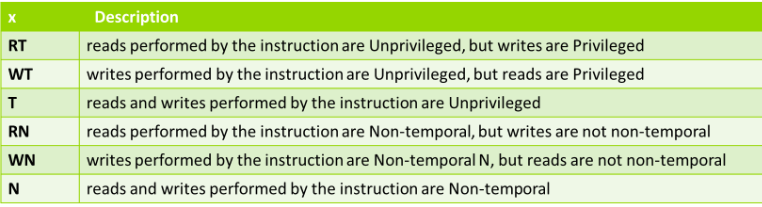
Memcpy, Memset指令额外访问控制
指令中的x用来额外指示访问是不是non-temporal和是不是以特权级方式访问。 例如CPYPTN, CPYMTN, CPYETN。
https://elixir.bootlin.com/linux/v6.13.6/source/arch/arm64/lib/memset.S#L207
#ifdef CONFIG_AS_HAS_MOPS
.arch_extension mops
SYM_FUNC_START(__pi_memset)
alternative_if_not ARM64_HAS_MOPS
b __pi_memset_generic
alternative_else_nop_endif
mov dst, dstin
setp [dst]!, count!, val_x
setm [dst]!, count!, val_x
sete [dst]!, count!, val_x
ret
SYM_FUNC_END(__pi_memset)
SYM_FUNC_START(__pi_copy_page)
#ifdef CONFIG_AS_HAS_MOPS
.arch_extension mops
/*
* Copy a page from src to dest (both are page aligned)
*
* Parameters:
* x0 - dest
* x1 - src
*/
SYM_FUNC_START(__pi_copy_page)
#ifdef CONFIG_AS_HAS_MOPS
.arch_extension mops
alternative_if_not ARM64_HAS_MOPS
b .Lno_mops
alternative_else_nop_endif
mov x2, #PAGE_SIZE
cpypwn [x0]!, [x1]!, x2!
cpymwn [x0]!, [x1]!, x2!
cpyewn [x0]!, [x1]!, x2!
ret
.Lno_mops:
Arm memcpy, memset指令过程中的中断和异常处理
对于任何数据大小的memcpy, memset,都可以使用Prolog, Main, Epilog三条指令来实现,例如,
CPYP [Xd]!, [Xs]!, Xn!
CPYM [Xd]!, [Xs]!, Xn!
CPYE [Xd]!, [Xs]!, Xn!
架构必须考虑这三条指令的过程中,如果出现中断或异常,应该怎样处理,如果等到这些指令完成全部拷贝才能响应中断或异常,那么会带来大的中断异常延时。想象一下如果拷贝几MB甚至更大的内存的场景。
因此架构允许在每个阶段过程中可以响应中断或异常, 在响应中断或异常时:
- 硬件更新Xn, Xs, Xd寄存器为Prolog, Main或是Epilog过程中第一个还没有被memcpy或是memset的元素,以便中断异常返回时,可以继续未完成的memcpy或是memset
- 在这个时间点之前的所有内存都被写更新
- 硬件设置ELR_ELx异常返回地址为被中断的指令地址
这样的处理使得被中断的Prolog, Main或是Epilog过程可以不需要软件特别处理就可以在中断异常返回后继续。
总结
通过FEAT_MOPS引入专门的memcpy, memset指令,可以让软件通过简单三条指令(Prolog, Main,Epilog三步)完成任何数据大小,地址对齐的memcpy, memset操作。同时让CPU微架构实现硬件自己来优化内存访问过程,让memcpy, memset这类软件中最常用的操作标准化,从而避免不同的memcpy, memset函数实现带来的软件复杂度。FEAT_MOPS让Arm平台软件更加简单标准高效。
更多有关FEAT_MOPS特性,请参照Arm架构文档,https://developer.arm.com/documentation/ddi0487/latest/
Re-use is only permitted for informational and non-commercial or personal use only.